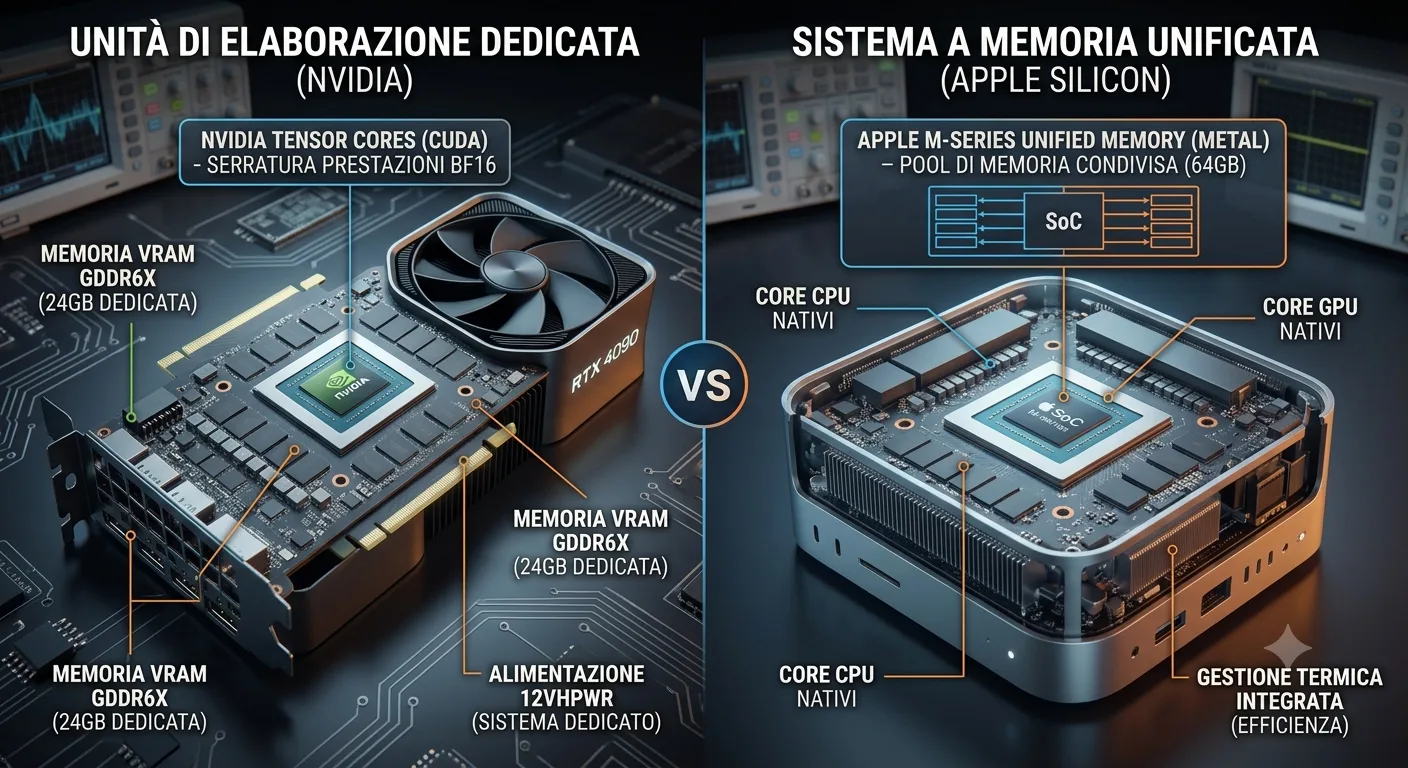
Oltre i CUDA Core: RAM Unificata (Apple Silicon) vs VRAM Dedicata (Nvidia) nel Training Locale di Modelli Generativi

Il training locale di modelli AI non è solo una questione di TFLOPS, ma di gestione dei colli di bottiglia della memoria. Questa analisi tecnica mette a confronto l'architettura a Memoria Unificata (UMA) di Apple Silicon con la VRAM Dedicata di Nvidia (CUDA). Scopriremo come la gestione dei tensor buffer, la scelta degli ottimizzatori (come 8-bit AdamW vs Metal Performance Shaders) e le strategie di allocazione software impattino direttamente sui workflow di training locali (LoRA ed Embeddings), svelando trucchi e configurazioni avanzate per spremere al massimo entrambi i sistemi.

0 commenti Commenta ↓

Tabella Comparativa Tecnico-Pratica

La seguente tabella riassume l'impatto delle scelte architetturali sulla configurazione di un training LoRA (es. su base SDXL o Flux):

Parametro / Feature Ecosistema Nvidia (VRAM Dedicata) Ecosistema Apple Silicon (UMA)
Precisione Nativa Raccomandata BF16 (Nativa su serie 30/40/50) FP16 (Miglior supporto su backend MPS)
Ottimizzatore Ideale AdamW8bit (BitsAndBytes) AdamW (PyTorch nativo) o Adafactor
Ottimizzazione Attenzione FlashAttention-2 / XFormers SDPA (Scaled Dot-Product Attention)
Gestione del Dataset Caricato in RAM, inviato a blocchi (Batch) in VRAM Resiede nella memoria condivisa, zero costo di trasferimento
Comportamento al Limite Crash Immediato (Out Of Memory) Rallentamento progressivo (Memory Swap su SSD)
Argomenti: #Apple #CUDA #nvidia

📬 Ti è piaciuto questo contenuto?

Iscriviti alla newsletter: ricevi le novità direttamente nella tua email ogni fine settimana. Niente spam, disiscrizione con un clic.

Notizie collegate

Le notizie legate a questo approfondimento

Vedi tutti →
Ti è piaciuto? Vota
— Nessun voto

Commenti (0)

Ancora nessun commento. Inizia tu la discussione.

L'email non verrà pubblicata: serve solo per avvisarti se qualcuno risponde al tuo commento.

I commenti dei visitatori vengono pubblicati dopo l'approvazione della redazione. Se preferisci, puoi accedere per pubblicare subito.