Strategie di Ottimizzazione della Pipeline di Training
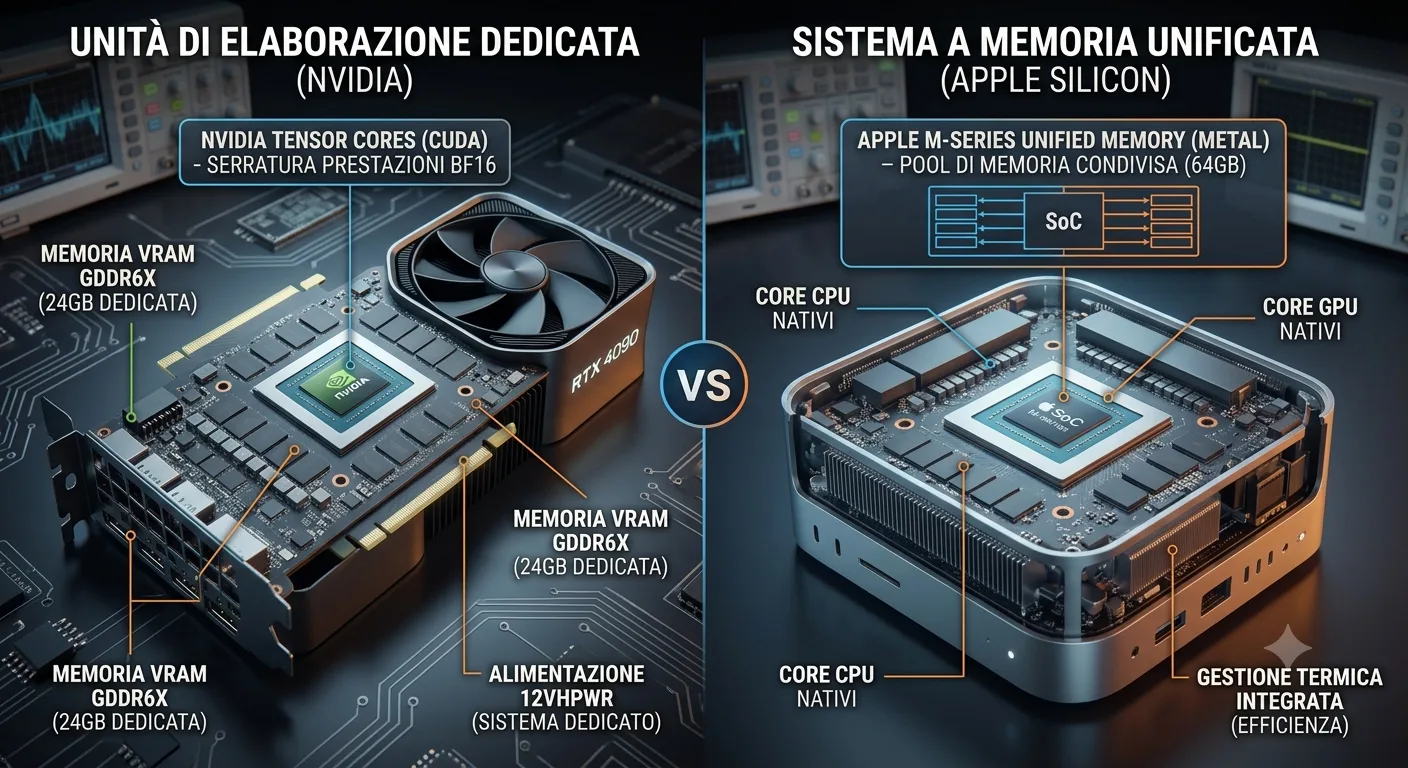
Per evitare colli di bottiglia e massimizzare i passaggi per secondo (it/s), la configurazione dei parametri deve riflettere l'hardware sottostante.
Ottimizzazione per Nvidia (Saturazione dei Tensor Core)
L'obiettivo su Nvidia è riempire la VRAM il più possibile senza toccare il limite di OOM, massimizzando il parallelismo dei Tensor Core.
-
Batch Size Elevati ed Esponenti di 2: I Tensor Core lavorano al massimo dell'efficienza quando le dimensioni delle matrici sono multipli di 8 o 16. Impostare
train_batch_sizea 4, 8 o 16 accelera matematicamente il calcolo. -
Gradient Accumulation Steps: Se la VRAM è limitata (es. 12-16GB) e non consente un batch size reale elevato, impostare il batch a 1 o 2 e usare
gradient_accumulation_steps=4per simulare un batch più grande senza saturare la memoria. -
Memory Efficient Attention: Attivare tassativamente XFormers o FlashAttention-2 nei parametri di training. Riducono l'impatto di memoria dell'algoritmo di attenzione da quadratica
O(N²)a lineareO(N), liberando preziosi gigabyte di VRAM.
Ottimizzazione per Apple Silicon (Prevenzione dello Swap di Sistema)
L'obiettivo su Apple Silicon è evitare che macOS utilizzi il file di swap sul disco SSD, evento che rallenterebbe il training di un fattore 10x.
-
Batch Size Ridotti e Micro-Batching: Poiché la potenza di calcolo grezza dei core grafici di Apple (anche su configurazioni con molte GPU Core) è inferiore alla densità dei Tensor Core di Nvidia, batch size troppo elevati (es. superiori a 4 o 8 su modelli grandi) saturano la capacità di calcolo simultaneo, portando a colli di bottiglia termici o di throttling. Meglio un batch più piccolo (1 o 2) abbinato a un dataset ben strutturato.
-
Soglia di Allocazione MPS: Di default, PyTorch su Mac tende ad essere conservativo nell'allocare la memoria unificata per evitare di bloccare il sistema operativo. È possibile forzare PyTorch a rilasciare la memoria non utilizzata o ad allocare blocchi più grandi impostando la variabile d'ambiente nel terminale prima del training:
Bashexport PYTORCH_MPS_HIGH_WATERMARK_RATIO=0.0(Questo disattiva il limite superiore di allocazione, permettendo a PyTorch di sfruttare quasi l'intera RAM unificata libera).
-
No XFormers, Sì Attenzione Nativa: I binari di XFormers sono compilati per CUDA. Su Mac, forzare l'uso di XFormers causerà un crash. È necessario impostare l'attenzione su SDPA (Scaled Dot-Product Attention), che PyTorch mappa nativamente sulle API Metal di Apple in modo altamente ottimizzato.
Commenti (0)
Ancora nessun commento. Inizia tu la discussione.