 NotiziaHardware
Schede pronte nei magazzini, ma la VRAM blocca tutto: NVIDIA congela le RTX 50 Super
Con i moduli GDDR7 da 3GB arrivati a costare fino a tre volte rispetto alle versioni da 2GB, il costo di produzione delle schede da 18GB e 24GB è schizzato alle stelle. NVIDIA ha congelato la distribuzione per evitare prezzi di listino fuori da ogni logica di mercato: ecco cosa sta succedendo.
NotiziaHardware
Schede pronte nei magazzini, ma la VRAM blocca tutto: NVIDIA congela le RTX 50 Super
Con i moduli GDDR7 da 3GB arrivati a costare fino a tre volte rispetto alle versioni da 2GB, il costo di produzione delle schede da 18GB e 24GB è schizzato alle stelle. NVIDIA ha congelato la distribuzione per evitare prezzi di listino fuori da ogni logica di mercato: ecco cosa sta succedendo.
 NotiziaHardware
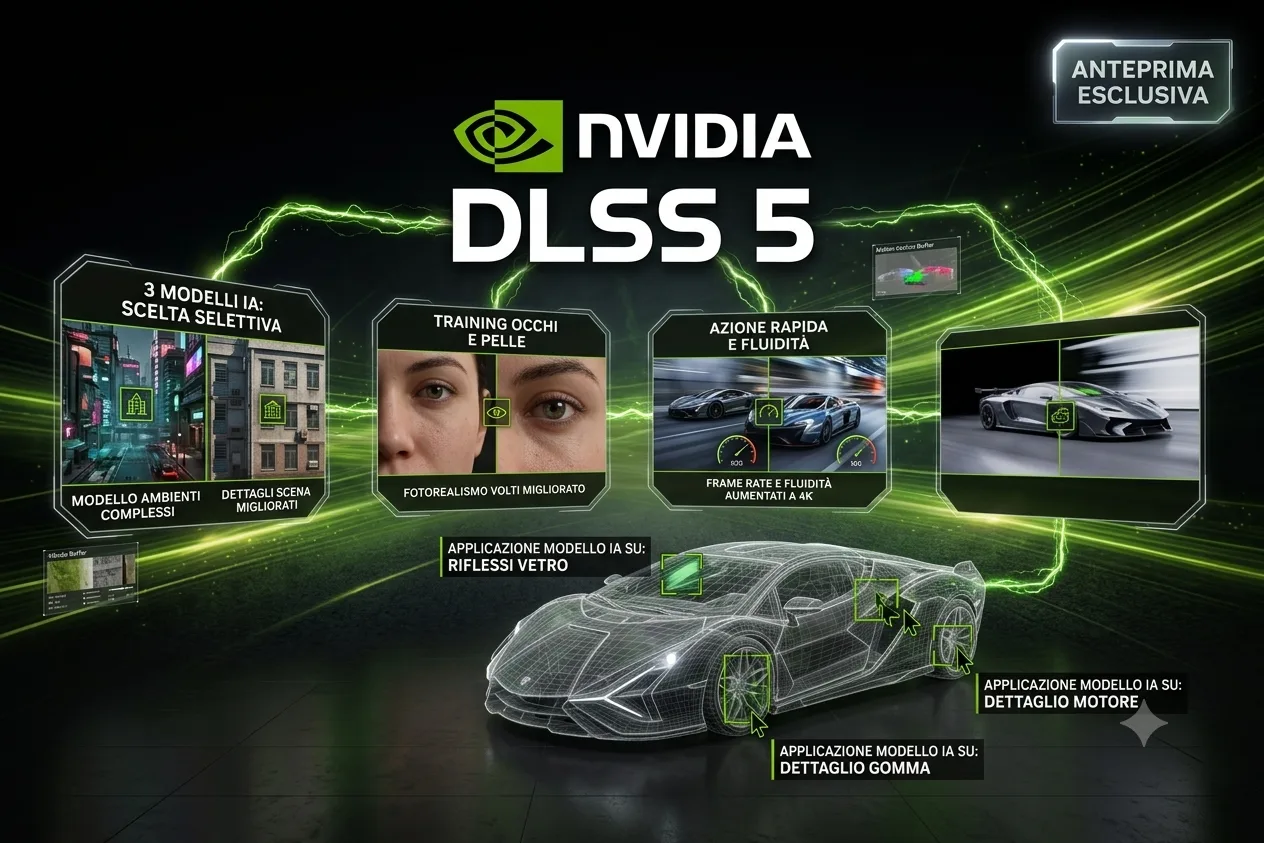
NVIDIA svela i dettagli del DLSS 5: 3 modelli IA e controllo granulare fino al singolo oggetto
Dimenticate il semplice upscaling: con tre nuovi modelli IA e controlli granulari per scena e asset, il DLSS 5 trasforma il frame con materiali e luci fotorealistiche. Ecco come funziona la nuova svolta grafica in arrivo in autunno.
 NotiziaIntelligenza Artificiale
Perplexity sceglie le CPU Vera di Nvidia: crolla il muro di Intel e AMD nei server AI
Nvidia punta a scardinare il duopolio x86 nei data center: Perplexity adotta le nuove CPU "Vera" basate su architettura custom Arm (core Olympus), registrando prestazioni fino a 1.5x superiori nei carichi di lavoro single-thread legati agli agenti IA rispetto ai processori tradizionali Intel e AMD.
 ArticoloIntelligenza Artificiale
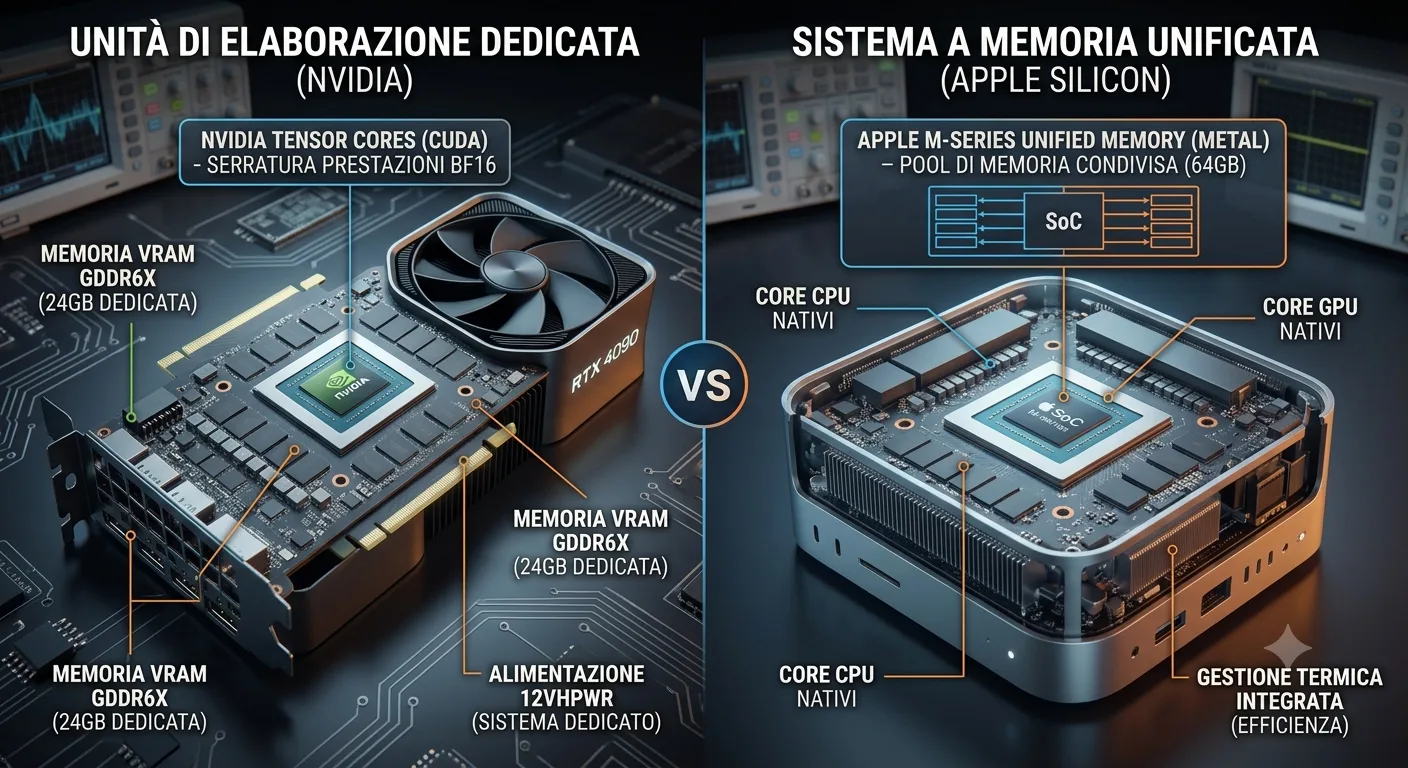
Oltre i CUDA Core: RAM Unificata (Apple Silicon) vs VRAM Dedicata (Nvidia) nel Training Locale di Modelli Generativi
Il training locale di modelli AI non è solo una questione di TFLOPS, ma di gestione dei colli di bottiglia della memoria. Questa analisi tecnica mette a confronto l'architettura a Memoria Unificata (UMA) di Apple Silicon con la VRAM Dedicata di Nvidia (CUDA). Scopriremo come la gestione dei tensor buffer, la scelta degli ottimizzatori (come 8-bit AdamW vs Metal Performance Shaders) e le strategie di allocazione software impattino direttamente sui workflow di training locali (LoRA ed Embeddings), svelando trucchi e configurazioni avanzate per spremere al massimo entrambi i sistemi.