 NotiziaIntelligenza Artificiale
Il grande esodo dal Cloud SaaS: perché tutti stanno portando i modelli AI in locale (e le API vi stanno prosciugando)
Dalle bollette stellari delle API a gettone ai silent downgrade che azzoppano i prompt dall'oggi al domani: aziende e sviluppatori stanno abbandonando i giganti closed-source per abbracciare i modelli Open Weight On-Premise. Spoiler: la VRAM si paga, ma l'affetto del Cloud costa molto di più.
NotiziaIntelligenza Artificiale
Il grande esodo dal Cloud SaaS: perché tutti stanno portando i modelli AI in locale (e le API vi stanno prosciugando)
Dalle bollette stellari delle API a gettone ai silent downgrade che azzoppano i prompt dall'oggi al domani: aziende e sviluppatori stanno abbandonando i giganti closed-source per abbracciare i modelli Open Weight On-Premise. Spoiler: la VRAM si paga, ma l'affetto del Cloud costa molto di più.
 ArticoloIntelligenza Artificiale
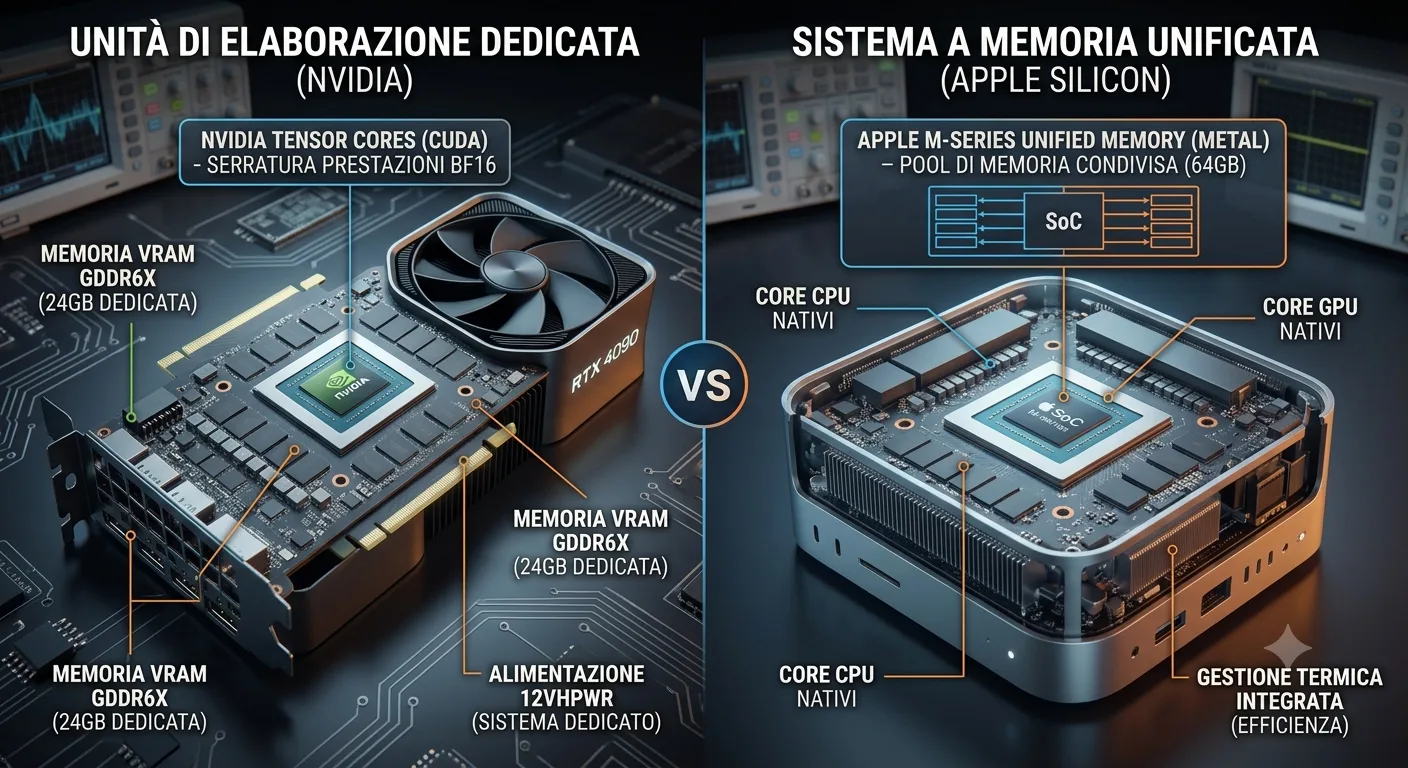
Oltre i CUDA Core: RAM Unificata (Apple Silicon) vs VRAM Dedicata (Nvidia) nel Training Locale di Modelli Generativi
Il training locale di modelli AI non è solo una questione di TFLOPS, ma di gestione dei colli di bottiglia della memoria. Questa analisi tecnica mette a confronto l'architettura a Memoria Unificata (UMA) di Apple Silicon con la VRAM Dedicata di Nvidia (CUDA). Scopriremo come la gestione dei tensor buffer, la scelta degli ottimizzatori (come 8-bit AdamW vs Metal Performance Shaders) e le strategie di allocazione software impattino direttamente sui workflow di training locali (LoRA ed Embeddings), svelando trucchi e configurazioni avanzate per spremere al massimo entrambi i sistemi.