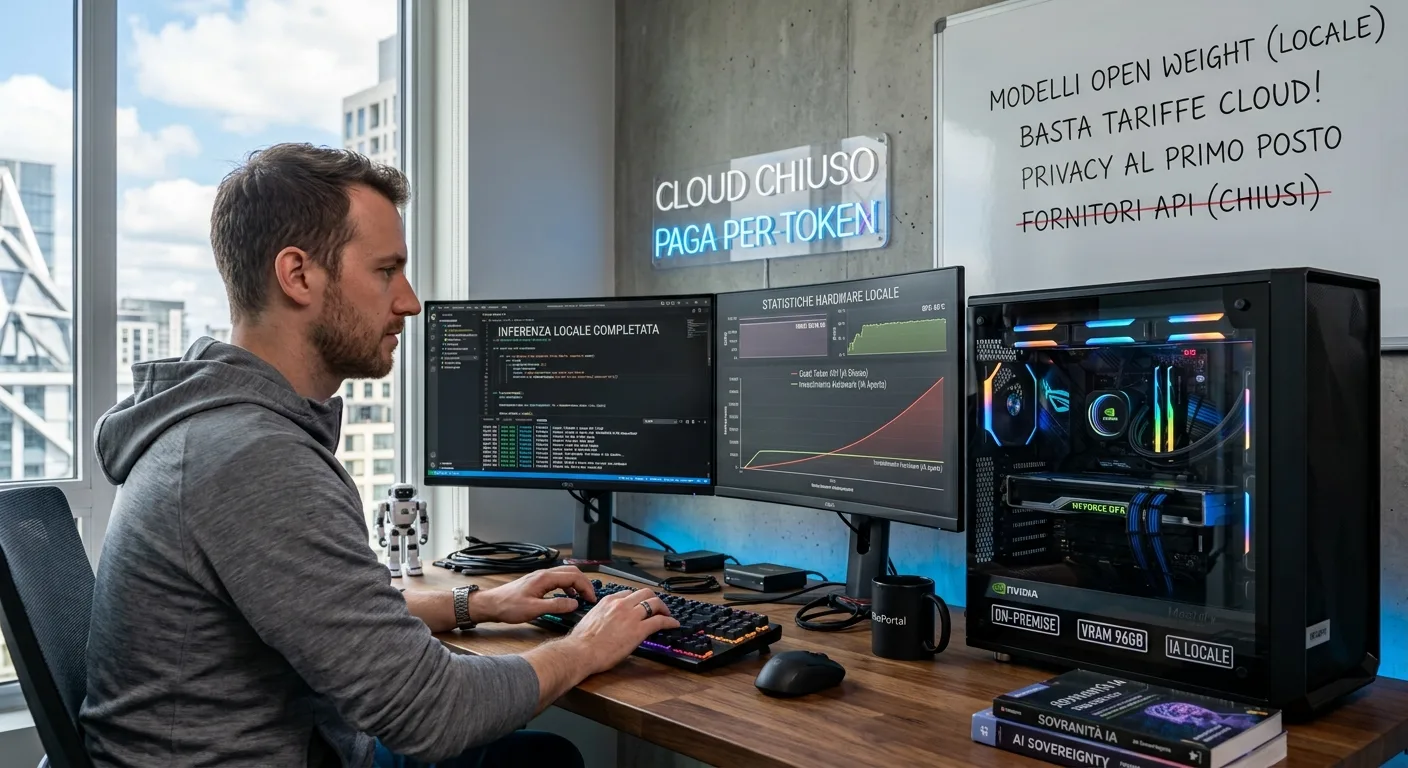
La luna di miele con le API in Cloud dell'Intelligenza Artificiale è ufficialmente finita.
All'inizio il patto sembrava perfetto: niente hardware dedicato da acquistare, nessuna configurazione complessa di driver CUDA o ambienti PyTorch. Bastava generare una chiave API su OpenAI o Anthropic, piazzare due righe di codice per fare una chiamata cURL e voilà: la potenza di calcolo della Silicon Valley a portata di click, pagando solo pochi centesimi per milione di token.
Poi sono arrivati gli agenti autonomi, la programmazione assistita e le pipeline aziendali complesse. E il risveglio è stato brutale.
La trappola dei token negli Agentic Workflows
Il modello "pay-per-token" funzionava finché ci limitavamo a usare ChatGPT come un Google sotto steroidi: una domanda, una risposta. Ma nel momento in cui l'AI viene integrata in workflow reali — dove gli agenti autonomi analizzano repository di codice, eseguono test, correggono i propri errori e ciclano in loop per decine di turni prima di restituire un risultato — il consumo di token non cresce in modo lineare: esplode.
Un singolo task di refactoring o l'analisi di un documento complesso può facilmente inghiottire centinaia di migliaia di token d'input tra contesto, memoria storica e retries. Risultato? Aziende e sviluppatori indie si ritrovano a fine mese con fatture Cloud a quattro zeri per servizi che, fino al mese prima, parevano "economici".
Flusso Tradizionale:  [Utente] ---> (1 Prompt) ---> [API Cloud] ---> (1 Risposta) = 2.000 Token
Flusso ad Agenti:     [Utente] ---> [Agente] <---> [Tool / Code / Shell] (50 Loop) ---> = 1.500.000 Token
Il dramma dei "Silent Downgrade" e della Privacy
I costi, per quanto fuori controllo, sono solo metà del problema. L'altro grande elefante nella stanza si chiama affidabilità.
Chiunque sviluppi su API SaaS "black box" ha provato sulla propria pelle l'esperienza del silent downgrade: da un giorno all'altro, senza alcun preavviso nel changelog, la propria pipeline smette di funzionare. Il motivo? La casa madre ha aggiornato il modello da remoto per tagliare i costi di inferenza, aumentare i filtri di sicurezza o ridurre la latenza, devastando il system prompt su cui avevate speso settimane di fine-tuning.
A questo si aggiunge la questione annosa della privacy e del segreto industriale: inviare codice sorgente proprietario, log di rete o database clienti sui server di terzi in California (o in Cina) sta diventando un rischio legale ed economico che sempre meno realtà sono disposte a correre.
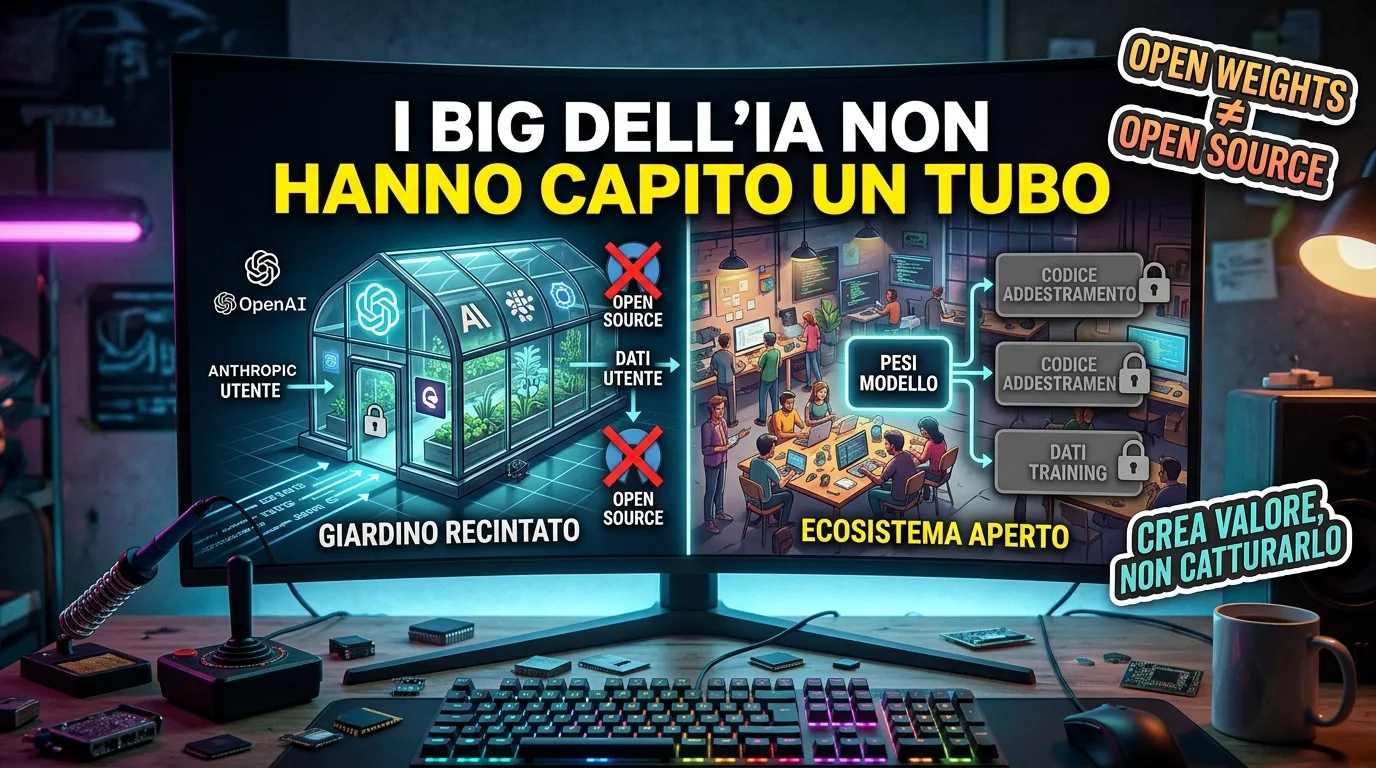
La riscossa degli Open Weight: il ferro batte il canone
Mentre OpenAI e Anthropic alzano le barriere dei loro ecosistemi chiusi, la community open source e i colossi come Meta, Alibaba e Mistral hanno colmato il gap tecnico a una velocità impressionante.
Modelli Open Weight con architetture avanzate (come Llama 3, Qwen 2.5 o DeepSeek) e parametri compresi tra gli 8B e i 70B — specie se quantizzati in formato GGUF o EXL2 a 4 o 8 bit — offrono oggi prestazioni sovrapponibili ai modelli closed di prima fascia nelle mansioni di codifica, sintesi ed estrazione dati.
La differenza? Girano in locale.
| Parametro | Cloud SaaS (API) | On-Premise (Open Weight) |
| Costo d'Esercizio | Variabile, esponenziale a token | Fisso (solo costo dell'hardware e corrente) |
| Data Privacy | I dati transitano su server terzi | 100% Locale / Air-Gapped |
| Controllo Modello | Sotto il controllo del vendor (soggetto a modifiche) | Congelato, riproducibile al 100% |
| Latenza | Dipende dalla rete e dai server del provider | Deterministica e saturabile sull'hardware locale |
VRAM Unificata e Workstation dedicate: il nuovo ROI
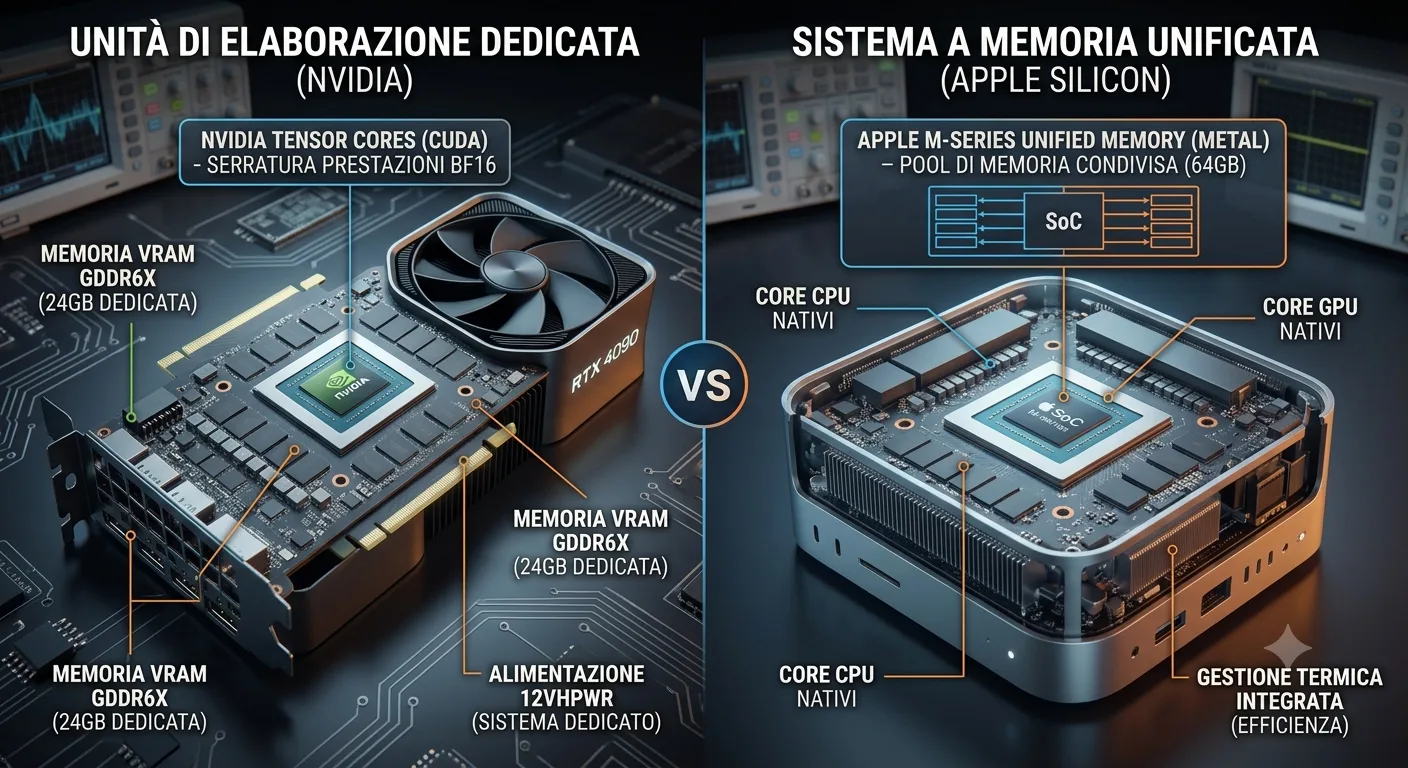
Il passaggio all'On-Premise non significa dover acquistare per forza un server rack con quattro Nvidia H100 da mezzo milione di euro. La vera rivoluzione sta avvenendo sul segmento delle workstation desktop di fascia alta:
-
Architetture a Memoria Unificata: Macchine da lavoro dotate di ampie riserve di RAM ad alta banda (come le configurazioni Apple Silicon fino a 128GB o 192GB di memoria condivisa) permettono di caricare in memoria modelli da 70B interamente in VRAM senza colli di bottiglia nel bus PCIe.
-
Rig Multiprocessore / Multi-GPU: Il mercato dell'usato e le schede da workstation permettono di assemblare cluster locali capaci di gestire inferenze massive con un ammortamento dei costi che si completa spesso in meno di 6 mesi di "mancate fatture API".
In conclusione
Il Cloud è stato fondamentale per farci capire di cosa fosse capace l'Intelligenza Artificiale. Ma esattamente come avvenuto per il Web hosting vent'anni fa, la fase pionieristica del "tutto in affitto" sta lasciando il posto al pragmatismo architetturale.
Comprare il "ferro", gestire la memoria locale e padroneggiare la quantizzazione dei modelli richiede competenze tecniche reali — non basta più inserire una carta di credito e copiare un token API. Ma per chi sviluppa software o gestisce dati sensibili, la sovranità tecnologica e il controllo dei costi non sono più un lusso: sono l'unico modo per sopravvivere nell'era dell'AI generativa.
Commenti (0)
Ancora nessun commento. Inizia tu la discussione.